
切换深色模式
1-DBMS-Outline
1-DBMS Outline
数据库管理系统(Database Management System,DBMS)是用于定义、存储、查询、操作和维护数据库的软件系统。
可以把它理解为应用程序与底层数据文件之间的管理层:应用程序提出“需要哪些数据,如何修改”,DBMS 负责高效、正确且安全地完成操作。
1. What is a Database Management System
举例说明:学校需要管理学生信息、课程信息以及选课记录
| 概念 | 含义 | 学校选课系统中的例子 |
|---|---|---|
| 数据(Data) | 记录下来的事实 | 学号、姓名、课程编号、成绩 |
| 数据库(Database) | 按一定结构组织起来的数据集合 | 全部学生、课程和选课记录 |
| 数据库管理系统(DBMS) | 管理数据库的软件 | MySQL、PostgreSQL 等 |
在关系型数据库(RDBMS)中,学校的数据可以组织成三张表:
Student(student_id, name, major)
Course(course_id, course_name, capacity)
Enrollment(student_id, course_id, grade)
应用程序可以向 DBMS 提交 SQL,找出专业为 Statistics 的学生姓名:
sql
SELECT name
FROM Student
WHERE major= 'Statistics'
用户不必指定学生记录在哪个文件、位于哪个字节、如何读取。DBMS 会把这个请求转化成实际的数据访问操作。
需要注意:DBMS 是更广泛的概念,RDBMS 是其中一类。文档、键值、图等数据库系统也属于 DBMS。下面主要围绕关系型 DBMS 解释。
2. Why do we need DBMS
最直接的问题是:既然文件也能保存数据,为什么还要使用 DBMS?
假设学校用三个 CSV 文件保存学生、课程和选课记录。数据量很小、只有一个人操作时,这种方式完全可行。但随着系统扩大,应用程序必须自行解决越来越多的问题。
(1)方便地查询和更新数据
如果要查询:
选修数据库课程、成绩超过 85 分的统计学学生。
使用普通文件,你需要自己编写程序,读取文件、寻找记录、关联学生与选课数据、执行筛选。
使用 DBMS,可以直接表达查询要求:
sql
SELECT s.student_id, s.name, e.grade
FROM Student AS s
JOIN Enrollment AS e
    ON s.student_id = e.student_id
JOIN Course AS c
    ON e.course_id = c.course_id
WHERE s.major = 'Statistics'
  AND c.course_name = 'Database'
  AND e.grade > 85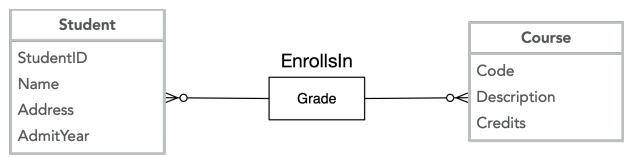
(2)提高大规模数据访问效率
假设有
如果建立适当的树形索引,定位记录所需的索引层数通常为:
其中
DBMS 还会管理内存缓存、选择连接算法、优化执行顺序。实际性能不仅取决于计算次数,还高度依赖需要访问多少数据页、产生多少磁盘 I/O。
(3)维护数据完整性
学校的数据需要满足规则,例如:
- 两个学生不能拥有相同的学号。
- 选课记录中的学生必须真实存在。
- 成绩必须在允许的范围内。
DBMS 可以通过主键、外键、检查约束等机制实施这些规则。
例如,主键约束表达:
这样,规则由数据库统一执行,而不必依赖每个应用都正确地实现一遍。
不过,DBMS 不会自动识别所有业务规则;开发者仍然需要定义约束和事务逻辑。
(4)处理多个用户同时操作
假设数据库课程只剩一个名额,小张和小李同时选课:
- 小张读取:剩余名额为 1
- 小李读取:剩余名额也为 1
- 两人都认为自己可以选课
如果缺少并发控制,可能出现超额选课。
DBMS 提供事务、锁以及多版本并发控制等机制,帮助应用正确处理同时发生的读写。
(5)在故障后保持数据可靠
一次选课可能包含两个操作:
- 插入选课记录
- 减少剩余名额
如果第一个完成后系统断电,而第二个尚未完成,数据就可能不一致。
DBMS 可以将这些操作组织成一个事务,使其具有“全部完成或全部不生效”的性质,并利用日志等机制进行故障恢复。
(6)管理权限并降低应用对存储细节的依赖。
学生只能查看自己的成绩,教师可以修改所教课程的成绩,管理员可以维护课程信息。DBMS 提供权限控制机制。
同时,即使数据库内部改变了文件布局或增加了索引,应用通常仍能继续使用原来的 SQL。这体现了数据独立性(Data Independence)。
因此,DBMS 的价值可以概括为:
把数据管理中的查询、效率、完整性、并发、安全和恢复问题,交给一个统一的软件系统处理
3. How dose DBMS manage data
可以从两个方面理解:数据如何被组织和请求被如何执行。
首先,DBMS 将数据的逻辑结构与物理存储分开。
| 层次 | 关注的问题 | 例子 |
|---|---|---|
| 外部层/视图层 | 某个用户或应用能看到什么? | 学生只能看到自己的成绩 |
| 逻辑层 | 数据有哪些结构和关系? | 学生表、课程表、选课表及其约束 |
| 物理层 | 数据实际怎样存储和访问? | 文件、数据页、记录、索引 |
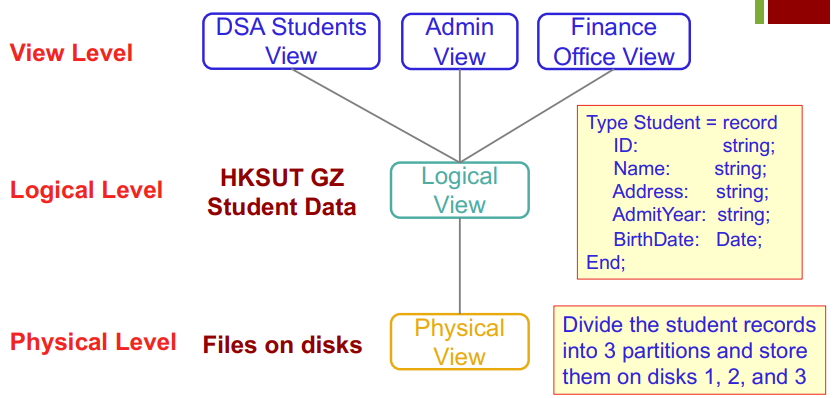
例如,从逻辑层看,Student 是一张表;从物理层看,它的数据可能分布在许多文件页中。
表是一种逻辑组织形式,不意味着磁盘上一定存在一个与之完全对应的连续表格。
在许多基于磁盘的 DBMS 中,数据按固定大小的页(Page)组织。一个页可以包含多条记录,DBMS 通常以页为基本单位,在持久化存储与内存之间搬运数据。
看一次查询的处理过程:
SELECT name
FROM Student
WHERE student_id = 20260001;
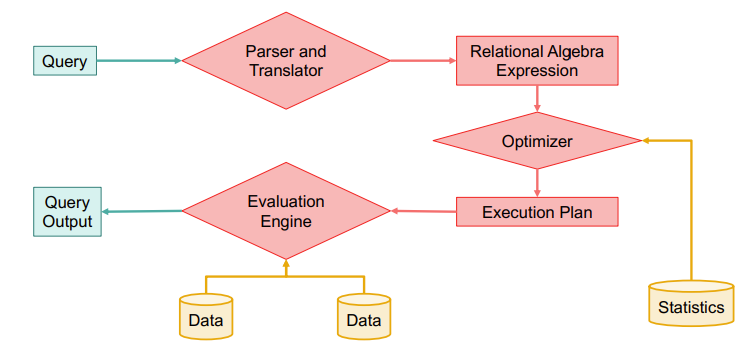
第一步:解析与检查。
DBMS 检查 SQL 语法,确认 Student 表和相应列存在,检查类型以及用户权限,并将语句转换成内部表示。
例如,它会判断:
这是一个先按学号筛选,再输出姓名的查询。
第二步:选择执行计划。
同一个查询可能有不同执行方式:
- 扫描整张学生表,逐条判断学号。
- 使用学号索引定位匹配记录。
查询优化器根据索引、表大小、数据分布统计等信息估计代价,选择一个预计成本较低的方案。
可以抽象写成:
其中:
:某个候选执行计划; :优化器实际考虑的计划集合; :估计的执行成本。
这里使用“估计”,是因为优化器并不事先知道每个计划的真实执行时间,也不一定穷举所有可能计划。
第三步:访问数据。
执行器按照计划执行,通过存储管理模块获取需要的数据页。
如果页面已在内存缓冲池中,就直接读取;否则,需要先从持久化存储加载到内存。
第四步:确定可见数据并返回结果。
存在并发事务时,DBMS 还需要根据隔离级别、锁或版本信息,决定本次查询可以看到哪些数据,然后将结果返回应用。
这些检查可能穿插在整个执行过程中,并非都发生在最后。
对于写入请求,DBMS 还会协调:
- 完整性约束检查;
- 并发访问控制;
- 数据和索引的修改;
- 日志记录;
- 事务提交或回滚。
4. What are the major components of a DBMS
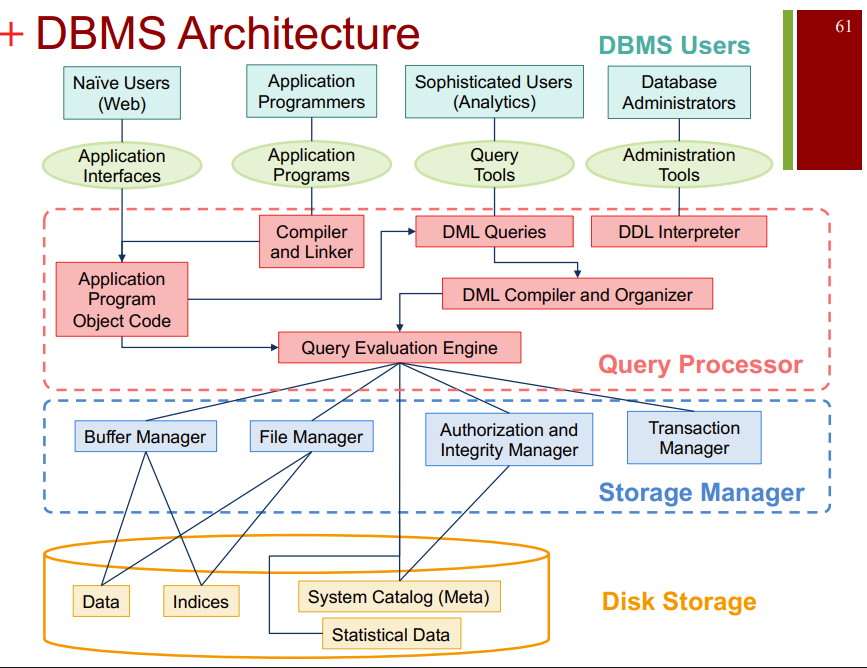
不同教材会使用不同的模块划分,但主要职责通常包括下面这些。
| 组件 | 核心职责 | 对应的直观问题 |
|---|---|---|
| 查询处理器(Query Processor) | 解析、优化并执行查询 | 用户的 SQL 应该怎样执行? |
| 存储管理器(Storage Manager) | 管理文件、页、记录和访问方法 | 数据存在哪里,怎样找到? |
| 缓冲池管理器(Buffer Pool Manager) | 管理内存中的数据页 | 哪些页留在内存,哪些需要加载或写回? |
| 事务与并发控制模块 | 管理事务以及并发操作之间的协调 | 多个人同时读写,如何保证正确性? |
| 日志与恢复模块(Recovery Manager) | 记录恢复信息,处理回滚和故障恢复 | 操作失败或系统崩溃后怎么办? |
| 系统目录(System Catalog) | 保存表结构、索引、约束、统计信息等元数据 | DBMS 如何知道数据库里有什么? |
| 授权与完整性管理模块 | 检查权限并实施数据约束 | 谁能操作,操作是否符合规则? |
Query Processor通常还能细分为:
| 子组件 | 作用 |
|---|---|
| 解析器与语义分析器(Parser and Translator) | 理解 SQL,检查表名、列名、类型等 |
| 查询优化器(Optimizer) | 比较候选方案,选择执行计划 |
| 查询执行器(Execution) | 执行扫描、筛选、连接、排序、聚合等操作 |
系统目录尤其容易被忽略。它保存的是“描述数据的数据”,也就是元数据(Metadata):
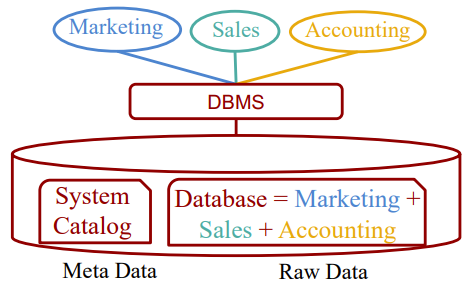
例如:
Student 表有哪些列?
student_id 是什么类型?
哪一列是主键?
表上建立了哪些索引?
表大约有多少行?
某一列的数据分布是什么样的?
优化器之所以知道“存在学号索引”,就是因为系统维护了这些信息。
最后,把这些组件放回一次操作中看:
用户提交 SQL,查询处理器理解并安排执行;存储与缓冲管理模块提供数据访问;事务模块协调并发;日志与恢复模块保障故障后的正确性;系统目录、权限与约束信息则为整个过程提供依据。