
切换深色模式
大模型预训练学习笔记
一、Decoder-only 的因果语言模型
1.1 预训练目标
1.1.1 数学形式
给定一个由 Token 组成的本文序列
其中
训练目标通常是最大化训练语料的似然:
等价于最小化负对数似然:
在深度学习实现中,这通常就是 cross entropy loss。
推理时,Decoder-only 则把“指令、上下文、回答”全部串成一个 token 序列:
1.1.2 从统计的角度看
对 token 序列
最大化训练数据的对数似然等价于最小化 next-token 交叉熵:
从统计角度看,这是对真实条件分布
证明:
其中:
所以理想情况下,最小化交叉熵就是缩小模型条件分布与真实条件分布之间的 KL 散度。
1.2 Decoder-only 的整体架构
Decoder-only Transformer 的主体结构并没有脱离原始 Transformer:
每个 Decoder Block 通常包含:
相对于原始 Transformer Decoder,Decoder-only 的架构:
- 去掉 Encoder;
- 去掉 Encoder–Decoder Cross-Attention;
- 保留带 causal mask 的 Self-Attention;
- 保留逐位置 FFN、残差连接、归一化;
- 最后用 LM Head 把隐藏向量映射成词表上的概率分布。
现代模型通常也不再原样使用 2017 Transformer 的配置,而常采用以下组合:
这些是常见设计,不是 Decoder-only 的数学定义;不同模型会选择不同变体。
1.2.1 一个 Decoder block 的计算
设第
Pre-Norm 中存在接近恒等映射的残差通路,梯度更容易穿过深层网络,通常比 Post-Norm 更适合大规模训练。
1.2.2 输入和输出流程
对位置
常见的 weight tying 令输出矩阵与输入词嵌入共享参数:
1.3 关键组件演进
在大模型预训练中,为了提升训练稳定性、收敛速度、数值效率和参数利用率,许多细节组件发生了系统性演进。这些变化看似是“工程细节”,但实际上直接影响大模型能否稳定扩展到几十亿、几百亿甚至更大规模。
1.3.1 归一化位置
1. Post-Norm:原始 Transformer 的结构
Post-Norm 结构,即先经过子层和残差连接,再做 LayerNorm:
具体到 Decoder Block 中,可以写成:
Post-Norm 的优点是每一层输出都经过归一化,因此表面上看数值范围较稳定。
但问题是:当模型很深时,梯度需要反向穿过多个 LayerNorm 和非线性模块,容易出现训练不稳定:
由于 LayerNorm 位于残差连接之后,残差路径也要经过 LayerNorm 的变换。这意味着原本应该提供稳定梯度通道的残差连接被 LayerNorm 限制住了。
2. Pre-Norm:现代大模型更常用的结构
Pre-Norm 把归一化放到子层之前:
具体到 Decoder Block:
这个结构中,残差主路径是:
因此至少有一部分梯度可以沿着近似恒等映射传播:
这使得深层网络更容易训练。
Pre-Norm 更稳定,但它也可能带来一个问题:由于每一层都是在残差主干上增加一个较小更新,模型深层部分的表示更新可能偏保守。
所以,从训练角度看,Pre-Norm 的本质作用是:
1.3.2 归一化方法
1. LayerNorm
给定某一层某个 token 的隐藏向量
其中:
它的作用是稳定不同层、不同 token 的激活分布。
2. RMSNorm:去掉均值中心化,只保留尺度归一化
RMSNorm 的核心思想是:
不减均值,只根据向量的均方根大小进行缩放。
给定
RMSNorm 写作:
RMSNorm 论文的核心假设是:LayerNorm 中的 re-centering invariance 不是必须的,因此可以只保留 re-scaling invariance,从而减少计算量。
1.3.3 激活函数
1. GELU
GELU,即 Gaussian Error Linear Unit,定义为:
其中
输入
是否被保留,不是由 这个硬阈值决定,而是由一个连续概率权重决定
2. SiLU
定义为:
它与 GELU 类似,也是一种“输入乘以门控函数”的形式。
从表达能力角度看:
1.3.4 前馈网络
1. 标准 FFN
Transformer 中的 FFN 是逐 token 作用的多层感知机。
给定隐藏向量
其中:
所以它先升维
直观上,Attention 负责 token 之间的信息交互,而 FFN 负责对每个 token 的表示进行非线性变换
2. GLU:引入门控机制
GLU,即 Gated Linear Unit,基本形式是:
其中:
:内容分支; :门控分支; :逐元素乘法。
从统计建模角度看,可以理解为输入相关的特征选择:
其中每个通道
3. SwiGLU:现代 LLM 中常见的 FFN 结构
SwiGLU 是 GLU 的一种变体,把 sigmoid gate 换成 SiLU / Swish 型门控:
然后再接输出投影:
GLU 变体研究表明,在 Transformer 中使用 GEGLU、SwiGLU 等门控 FFN 变体通常可以改善模型效果;这些变体后来也成为许多大模型的常见组件
4. 标准 FFN 与 SwiGLU 的结构对比
标准 FFN:
SwiGLU FFN:
核心区别是:
- 增强通道选择能力
- 提高非线性表达能力
1.3.5 注意力头
1. MHA
给定输入隐藏状态
每个头的注意力输出为:
最后把所有头拼接:
MHA 的优点是:每个头有独立的
但是在大模型推理阶段,MHA 有一个明显问题:KV Cache 很大
Decoder-only 模型是自回归生成
为了避免每一步都重新计算历史 token 的
对于 MHA,每一层、每个注意力头都要保存自己的 (K,V)。
如果模型有:
- 层数:
- 注意力头数:
- 序列长度:
- 每个头维度:
那么 KV Cache 的规模大致是:
当 batch size、上下文长度和层数都较大时,KV Cache 会成为推理显存和带宽瓶颈。
2. MQA
MQA, Multi-Query Attention 的核心思想是:
Query 仍然保留多个头,但所有 Query heads 共享同一组 Key 和 Value。
标准 MHA 是:
MQA 则在其基础上,
即:
也就是说:
KV Cache 规模变化:
当然,因为所有头共享
3. GQA
GQA, Grouped-Query Attention 是 MHA 和 MQA 之间的折中方案。
它的思想是:
Query heads 仍然有很多个,但 Key/Value heads 不是 1 个,而是分成若干组,每组 Query heads 共享一组 Key/Value。
例如:
则每 4 个 Query heads 共享一组 Key/Value。
QA 是当前很多 Decoder-only LLM 的常见选择,因为它在效果和推理效率之间取得平衡。
| 方法 | 表达能力 | KV Cache | 推理效率 |
|---|---|---|---|
| MHA | 强 | 大 | 慢 |
| MQA | 较弱 | 最小 | 快 |
| GQA | 接近 MHA | 明显降低 | 较快 |
可以理解为:
GQA 论文也强调,它可以在接近 MHA 质量的同时达到接近 MQA 的推理速度
1.3.6 参数初始化方式
参数初始化的核心目标是让前向传播和反向传播的尺度保持稳定。
理想情况下,希望:
如果初始化过大:
会很大,残差更新过强,训练初期容易不稳定。
如果初始化过小:
模型训练初期接近恒等映射,虽然稳定,但学习可能较慢。
所以初始化本质是在平衡:
1. 标准正态初始化
早期 GPT 类模型常使用类似正态初始化:
2. Xavier / Glorot 初始化
若输入维度为
前向传播方差分析
设
的各分量独立, ,协方差矩阵 的各元素独立, , 与 相互独立
计算
代回得到:
希望逐层传播后方差不变,即前向传播方差稳定条件
同样的方法,可以得到反向传播方差稳定条件:
想要同时保持前向和反向方差稳定,Xavier 的做法是取两者的调和平均:
常见形式:
或:
3. 残差分支缩放初始化
首先,我们看残差叠加带来的尺度问题。如果每一层都执行:
如果每个
如果有
这说明层数越深,残差累积可能导致激活尺度增大。
为了控制残差分支的输出尺度,可以让某些输出投影权重初始化更小,例如:
总结
| 模块 | 早期形式 | 现代常见形式 | 主要目的 |
|---|---|---|---|
| 归一化位置 | Post-Norm | Pre-Norm | 深层训练稳定 |
| 归一化方法 | LayerNorm | RMSNorm | 降低计算量,稳定尺度 |
| 激活函数 | ReLU | GELU / SiLU | 更平滑的非线性表达 |
| 前馈网络 | 标准 FFN | GLU / SwiGLU | 增强门控与通道选择 |
| 注意力头 | MHA | MQA / GQA | 降低 KV Cache,提高推理效率 |
| 残差路径 | 普通残差 | 更重视残差尺度控制 | 防止深层累积失控 |
| 参数初始化 | 普通初始化 | 深度相关初始化 / 残差缩放 | 控制前向与反向方差 |
| 训练配置 | Bias + Dropout 常用 | 减少 Bias / 减少 Dropout | 简化结构,提高大规模训练效率 |
1.4 MoE稀疏专家模型
MoE,全称 Mixture of Experts,即专家混合模型。在大语言模型中,它通常指:
所以 MoE 的核心不是“把模型变小”,而是:
在标准稠密 Transformer 中,每个 token 必须经过全部参数的计算。模型性能随参数量增长而提升(Scaling Laws),但推理 FLOPs、显存、延迟也线性增长。
MoE 的核心目标是解耦两件事:
总参数量(模型容量/知识储备)→ 可以非常大
每个 token 的激活参数量(实际计算量)→ 保持很小
1.4.1 核心架构
在标准 Decoder-only Transformer 中,每一层通常有一个 FFN:
所有 token 都经过同一个 FFN。
而 MoE 的思想是把一个 FFN 替换成多个专家,即
然后,对于每个 token 表示
给定 token 表示
然后通过一些方法将得分转化为概率权重:
其中
最后计算 MoE FFN:
其中:
:第 个专家网络; :第 个专家的权重; :专家总数。
如果所有专家都参与计算,这就是 dense MoE。
但大语言模型中常用的是 sparse MoE,即只激活少数专家,这是由
1.4.2 Top-k 稀疏激活
Top-k 稀疏激活:不是所有专家都参与计算,而是只选择得分最高的
定义:
其中:
表示 token
于是 Sparse MoE 的输出为:
其中:
表示在选中的 Top-k 专家内部重新归一化后的权重。
所以完整形式是:
总结:
1.4.3 专家容量与 Token 分配
1.4.4 负载均衡与辅助损失
1.4.5 Expert Parallelism 与 All-to-All 通信
1.4.6 MoE 的收益、代价与适用场景
二、Scaling Law
Scaling Law 可以理解为规模定律。在大语言模型预训练中,它关心的是:
更具体地说,它试图回答三个问题:
- 模型参数
增大,模型效果会怎么变? - 训练 token 数
增大,模型效果会怎么变? - 计算预算
固定时,应该把预算分给更大的模型,还是更多的数据?
通常记:
| 符号 | 含义 |
|---|---|
| 模型参数量,number of parameters | |
| 训练 token 数,dataset size | |
| 训练计算量,compute,常用 FLOPs 表示 | |
| 语言模型的预测损失,通常是 cross entropy loss |
2.1 核心幂律关系
2.1.1 Scaling Law 的基本形式
Scaling Law 的核心观察是:
Kaplan et al. 的 Scaling Laws for Neural Language Models 系统研究了模型大小、数据集大小和训练计算量与语言模型交叉熵损失之间的幂律关系,并指出这些趋势可跨越多个数量级。OpenAI
一个常见的通用形式是:
其中:
:给定规模 下的 loss; :不可约损失,表示即使规模无限增大也难以消除的部分; :常数系数; :幂律指数; :可以是模型参数量 、数据量 、计算量 。
也就是说,loss 的下降不是线性的,而是:
2.1.2 三种幂律
通用形式具体表现为三种幂律:
- 模型规模幂律:当数据充足、训练充分时,增大参数量可降低 loss:
- 数据规模幂律:当模型足够大时,增加训练 token 数可降低 loss:
- 计算量幂律:训练计算量
, 为非 embedding 参数量,系数 6 来自前向+反向传播的 FLOPs 估算),loss 随计算预算呈幂律下降:
所以 Scaling Law 告诉我们:
2.1.3 三种瓶颈
实际预训练时,模型效果可能被不同因素限制。
- 模型瓶颈:
太小,模型容量不足以吸收数据中的信息。此时继续增加数据收益有限,应优先扩大模型。 - 数据瓶颈:
不足,模型反复看相同数据,容易过拟合。此时继续增大模型不划算,应优先增加高质量 token。 - 计算瓶颈:
不足,训练步数不够,模型未充分收敛。此时无论模型还是数据多好,都无法达到预期 loss。
2.2 计算最优分配原则
2.2.1 问题:固定计算预算下,模型和数据怎么分配?
Scaling Law 最重要的实际问题是:
因为计算量近似满足:
所以当 (C) 固定时,预训练规划的核心矛盾是:
2.2.2 Kaplan Scaling Law:更重视增大模型
Kaplan et al. 的早期 Scaling Law 研究认为,在计算最优条件下,模型参数量应随计算预算增长得更快,而数据规模增长相对较慢。这个结论影响了早期大模型扩展路径,即更倾向于训练更大的模型。OpenAI
可以粗略理解为:
这条路线对应早期很多超大参数模型,例如 GPT-3 这类模型体现了“扩大参数规模带来 few-shot 能力提升”的思路;OpenAI 对 GPT-3 的介绍也强调,扩大语言模型显著提升了任务无关的 few-shot 性能
2.2.3 Chinchilla Scaling Law:模型和数据应近似等比例增长
后来的 Chinchilla 工作重新研究了计算最优训练问题,结论发生了重要变化:
Hoffmann et al. 在 Training Compute-Optimal Large Language Models 中指出,对于 compute-optimal training,模型大小和训练 token 数应当同时扩展;他们训练的 Chinchilla 使用与 Gopher 相同的计算预算,但参数量更小、训练数据约多 4 倍,并取得更好的效果。arXiv
形式上可以写成:
Chinchilla 结论中:
这意味着:
2.2.4 Chinchilla 的直观含义:很多大模型其实 under-trained
Chinchilla 结论的一个重要启发是:
也就是说,它们不是模型太小,而是数据看得不够多。
如果一个模型参数量非常大,但训练 token 数不足,那么它可能处于 under-trained large model状态。
此时,与其继续增加参数量,不如在相同计算预算下训练一个较小模型,但给它更多 token:
这可能获得更好的 loss 和下游表现。
2.2.5 计算最优的数学直觉
假设 loss 可以近似分解为:
其中:
:模型容量不足带来的误差; :数据不足带来的误差。
代入计算约束
所以存在一个优化方式:
这就是计算最优分配的本质。
2.3 对预训练规划的指导
在预训练规划中,最重要的不是单纯追求更大的参数量,而是求解:
也就是在固定计算预算下,找到模型规模 (N) 和训练 token 数 (D) 的最优匹配。
2.3.1 从硬件预算估计总计算量
2.3.2 选择模型参数规模和训练 Token 总量
2.3.3 由全局 Batch Size 推算训练步数
2.3.4 规划上下文长度与样本数量
2.3.5 通过小模型试验拟合 Scaling 曲线
在真正训练大模型之前,可以先训练一系列小模型,并使用不同 token 数:
得到实验点:
然后拟合:
如果拟合稳定,就可以外推到更大规模
2.3.6 为消融实验、评估与故障预留预算
小结:预训练规划的完整推导链条
Scaling Law 对预训练规划的指导可以整理成一条完整链路:
最终,预训练规划不是简单地决定一个模型大小,而是在求解:
其中:
:模型参数量; :训练 token 总量; :全局 batch token 数; :上下文长度; :主训练计算预算。
三、数据工程
3.1 数据在预训练中的核心地位
3.2 数据来源与类型
3.3 数据规模规划
3.4 数据清洗流水线
3.5 数据配比与混合策略
3.6 Tokenizer
四、完整训练流程
4.1 训练循环基础
可以把一次训练迭代理解为:
对于 Decoder-only 语言模型,训练目标通常是 next-token prediction:
也就是说,模型看到前面的 token,预测下一个 token。
4.1.1 Batch 读取与样本构造
文本数据首先被 tokenization
对于一段文本,tokenization 就是通过查对应的词表
Batch 构造
大模型训练时,不一定按照“句子”或“文章”作为基本单位,而是把大量语料拼接成一个很长的 token 序列。
例如我们将一个完整的训练语料拼接成一个长度
我们通常不会一次性将整个 token 序列全部输入到模型中训练,首先这对显存的要求很高,另外模型的长下文长度不支持。
大多时候,我们是将 token 序列切片为一个个固定长度的片段,记长度为
由于
标签右移:构造标签
4.1.2 前向传播与 Logits
将 token ID embedding:
经过模型主体:
这里不展开 Decoder-only 内部结构,比如 self-attention、causal mask、MLP、残差连接等,因为这些属于架构部分。
4.1.3 Token-level Loss
单个 token 的交叉熵损失
如果第
其中:
表示模型给第
单个 token 的交叉熵损失
一个 batch 中有
代入交叉熵形式:
Padding token 的处理
有时候,batch 中不同文本长度不同,可能需要 padding,而 padding 位置不应该参与 loss
因此通常会引入 mask:
loss 改为:
也就是说,只对真实 token 求平均,不让 padding 影响训练。
在很多大规模预训练场景中,数据会被拼接和截断成固定长度,所以 padding 可能较少;但在微调、对话数据训练或变长样本训练中,padding mask 很常见。
4.1.4 反向传播与梯度
最基础的梯度下降更新为:
其中:
:第 次参数更新; :学习率; :当前 batch 上计算得到的梯度。
梯度指向 loss 上升最快的方向,所以要沿着负梯度方向更新。
一次前向传播可以抽象为:
其中:
:输入 token; :hidden states; :logits; :loss。
反向传播使用链式法则:
现代深度学习框架会自动构建计算图,框架会自动沿着计算图从 loss 反向传播到每一层参数。
4.1.5 梯度累积与梯度裁剪
1. 梯度累积
为什么需要梯度累积?
大模型训练中,为了训练稳定,我们往往需要较大的 Global Batch Size(如 256、512 甚至更大)。但受限于 GPU 显存,单卡一次能塞进去的 Micro Batch Size 可能只有 4 或 8。
梯度累积的核心思想是:用多次小 batch 的前向/反向传播,模拟一次大 batch 的效果。
原理
假设 Global Batch Size = 32,单卡最多放 Micro Batch Size = 8,那么累积步数
具体流程:
- 取第 1 个 micro batch,前向传播,计算 loss,反向传播得到梯度
- 取第 2 个 micro batch,前向传播,计算 loss,反向传播得到梯度
- 取第 3 个 micro batch,前向传播,计算 loss,反向传播得到梯度
- 取第 4 个 micro batch,前向传播,计算 loss,反向传播得到梯度
- 将 4 次梯度求平均:
- 用
更新参数
- PyTorch 中
loss.backward()默认将梯度累加到param.grad上而非覆盖。- 标准训练中,我们在每次
backward()前调用optimizer.zero_grad()清零梯度,因此每次param.grad只保留当前 batch 的梯度。- 而梯度累积正是利用这一累加机制,故意在 k*k* 次
backward()之间不调用zero_grad(),使多次梯度在param.grad上叠加,最后统一更新参数。
2. 梯度裁剪
大模型训练中可能出现梯度过大,导致参数更新不稳定。
常见做法是梯度裁剪,有两种主流方法:
方法一:按范数裁剪(Gradient Clipping by Norm)
计算所有参数的梯度范数(
PyTorch 中常见写法:
python
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)方法二:按值裁剪(Gradient Clipping by Value)
直接将每个梯度元素截断到
直觉理解:对梯度的每个分量独立地"削峰",可能会改变梯度方向。
python
torch.nn.utils.clip_grad_value_(model.parameters(), clip_value=1.0)主流大模型(GPT、LLaMA 等)的预训练中,几乎都使用按范数裁剪,典型配置:
- 阈值
- 在每个 micro batch 的
backward()之后、optimizer.step()之前执行 - 配合梯度累积时,通常在最后一次 backward 之后统一裁剪
在 PyTorch 风格的训练循环中,一步训练通常是:
optimizer.zero_grad()

logits = model(input_ids)

loss = cross_entropy(
    logits.view(-1, vocab_size),
    labels.view(-1)
)

loss.backward()

torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

optimizer.step()
4.2 优化器
4.2.1 SGD
最基础的优化器是随机梯度下降,简称 SGD。
假设第
SGD 的更新规则是:
为什么叫随机梯度下降?
理论上的总体目标函数是:
也就是对整个数据分布求期望。
但实际训练时,我们不会每一步都用完整数据集计算梯度,因为其计算量很大,解决方法是从数据集中采样一个 mini-batch:
然后用 mini-batch loss 近似总体 loss:
对应的梯度:
是总体梯度无偏估计。"无偏"意味着平均来看方向是对的,但每一次具体采样都会有随机波动——这就是"随机"二字的来源
SGD 的问题
SGD 简单,但在大模型训练中通常不够稳定。
主要问题有三个:
| 问题 | 含义 |
|---|---|
| 梯度噪声大 | 每个 batch 只是总体梯度的近似 |
| 不同参数尺度不同 | 有些参数梯度大,有些参数梯度小 |
| 收敛路径震荡 | 在高曲率方向容易来回摆动 |
所以现代大模型训练通常不直接使用普通 SGD,而是使用带动量或自适应学习率的优化器。
4.2.2 Momentum
Momentum 的思想是:
不要只看当前 batch 的梯度,还要参考过去若干步的平均方向。
定义速度变量
其中:
:当前梯度; :梯度的指数滑动平均; :动量系数,常见取值如 。
参数更新为:
可以把 Momentum 理解为:
也就是历史梯度的加权平均,越近的梯度权重越大。
| SGD 的问题 | Momentum 的改善 |
|---|---|
| batch 梯度噪声大 | 历史平均可以降低噪声 |
| 路径震荡 | 高频震荡方向会被抵消 |
| 有效方向前进慢 | 一致方向会被加速 |
4.2.3 Adam
Adam(Adaptive Moment Estimation) 可以看作结合了两类信息:
- 一阶矩估计:梯度的滑动平均,类似 Momentum;
- 二阶矩估计:梯度平方的滑动平均,用来调整每个参数的步长。
设当前梯度为:
Adam 维护一阶矩(梯度方向的平均):
其中:
:梯度的一阶指数滑动平均; :一阶矩衰减系数,常见取值 (0.9)。
Adam 还维护二阶矩:梯度平方的平均:
其中:
:梯度平方的指数滑动平均; :二阶矩衰减系数,常见取值 ; 是逐元素平方
如果某个参数长期梯度很大,那么对应的
Adam 更新时会用
误差修正
由于 Adam 初始化时,
假设各步梯度
同理:
为了修正这种偏差,Adam 使用:
这其实是一个无偏化操作:
参数更新为:
Adam 的一轮完整更新可以写成:
Adam 的直观解释:
4.2.4 AdamW
现代大语言模型训练中,更常用的是 AdamW,而不是原始 Adam。
AdamW 的关键改动是:
把 weight decay 从梯度更新中解耦出来。
权重衰减
权重衰减的目标是限制参数规模,防止参数无限变大。
常见形式是在目标函数中加入
对它求梯度:
在 SGD 中,加入
可以看到,参数被乘上了一个衰减因子:
但是在 Adam 中,更新是:
如果把
AdamW 的更新方式
AdamW 将梯度更新和权重衰减分开。
先做 Adam 更新:
同时单独加入权重衰减:
其中:
:weight decay 系数; :直接对参数做衰减; - Adam 部分只处理数据 loss 的梯度。
| Adam + L2 | AdamW(解耦权重衰减) | |
|---|---|---|
| 正则项是否进入 $ m_t, v_t $ | ✅ 是 | ❌ 否 |
| 衰减是否被自适应学习率缩放 | ✅ 是(不均匀) | ❌ 否(等比例) |
| 大参数的衰减效果 | 偏弱 | 正常 |
| 小参数的衰减效果 | 偏强 | 正常 |
在大语言模型预训练中,常见优化器配置格式大致如下:
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=learning_rate,
    betas=(0.9, 0.95),
    eps=1e-8,
    weight_decay=0.1
)
4.2.5 不参与权重衰减的参数
在 AdamW 中,权重衰减表示在每次参数更新时,AdamW 会额外把参数往 0 的方向拉一小步:
这对很多权重矩阵是有益的,但并不是所有参数都应该参与 weight decay。
weight decay 的本质是限制参数规模:
它适合用于普通权重矩阵,例如:
这些参数通常具有较高维度,并且控制模型的主要表示能力。适当约束它们的范数,可以起到正则化作用。
但是某些参数的功能不是“学习复杂映射”,而是控制尺度、平移或特殊结构。对这些参数做 weight decay,可能会破坏它们的作用。
通常不参与 weight decay 的参数:
| 参数类型 | 是否 weight decay | 原因 |
|---|---|---|
| bias 参数 | 否 | 偏置项只负责平移,不适合用范数约束 |
| LayerNorm / RMSNorm 权重 | 否 | 归一化层参数控制尺度,衰减会干扰归一化效果 |
| BatchNorm 参数 | 否 | 类似归一化尺度参数,通常不衰减 |
| embedding 特殊参数 | 视情况 | 有些实现会衰减,有些不会 |
| 普通 Linear 权重矩阵 | 是 | 主要学习映射关系,适合正则化 |
在大语言模型中,最常见的规则是:
4.2.6 优化器状态的显存开销
在大模型训练中,显存不只被模型参数占用。
训练时显存主要来自:
其中,AdamW 的优化器状态非常占显存。
现代大模型训练通常使用 FP16 或 BF16 做前向和反向。FP16/BF16 每个数占
一种常见估算是:
| 对象 | 精度 | 显存 |
|---|---|---|
| 模型参数 | BF16 / FP16 | (2N) bytes |
| 梯度 | BF16 / FP16 | (2N) bytes |
| FP32 master weights | FP32 | (4N) bytes |
| Adam 一阶矩 (m) | FP32 | (4N) bytes |
| Adam 二阶矩 (v) | FP32 | (4N) bytes |
合计
为降低 AdamW 的优化器状态显存,常见方法包括:
| 方法 | 核心思想 |
|---|---|
| ZeRO Stage 1 | 切分 optimizer states |
| ZeRO Stage 2 | 进一步切分 gradients |
| ZeRO Stage 3 | 切分 parameters、gradients、optimizer states |
| optimizer offload | 把优化器状态放到 CPU 或 NVMe |
| 8-bit optimizer | 用低精度保存优化器状态 |
| Adafactor | 减少二阶矩存储 |
具体方法后面再研究。
4.3 学习率调度
在训练语言模型时,学习率 learning rate, LR 通常不是固定不变的,而是会随着训练步数动态调整。
学习率调度,就是设计一个函数:
使得学习率随着训练过程合理变化。
训练初期:学习率太大容易不稳定
训练后期:学习率太大不利于收敛
4.3.1 Learning Rate Warmup
1. Warmup 是什么?
Learning Rate Warmup 指的是:在训练初期,不直接使用较大的学习率,而是让学习率从一个很小的值逐步增加到目标最大值。
设 warmup 步数为
2. 为什么需要 Warmup?
训练刚开始时,模型参数通常是随机初始化的。此时:
模型输出非常不稳定,loss 也通常较大。对应的梯度可能存在较强波动:
如果一开始就使用较大的学习率,参数更新可能过大,从而引起训练不稳定。Warmup 的作用是让模型在训练初期先进行较温和的更新。
4.3.2 Constant、Linear 与 Cosine Decay
Warmup 结束后,学习率通常进入 decay 阶段。常见策略包括:
- Constant Learning Rate
- Linear Decay
- Cosine Decay
1. Constant Learning Rate
Constant 学习率指训练过程中学习率保持不变:
如果带 warmup,则通常是:
2. Linear Decay
Linear Decay 指学习率在 warmup 后从最大值线性下降到最小值。
设总训练步数为
先大步搜索,再小步收敛
3. Cosine Decay
Cosine Decay 指 warmup 后学习率按照余弦曲线下降:
整体形式为:
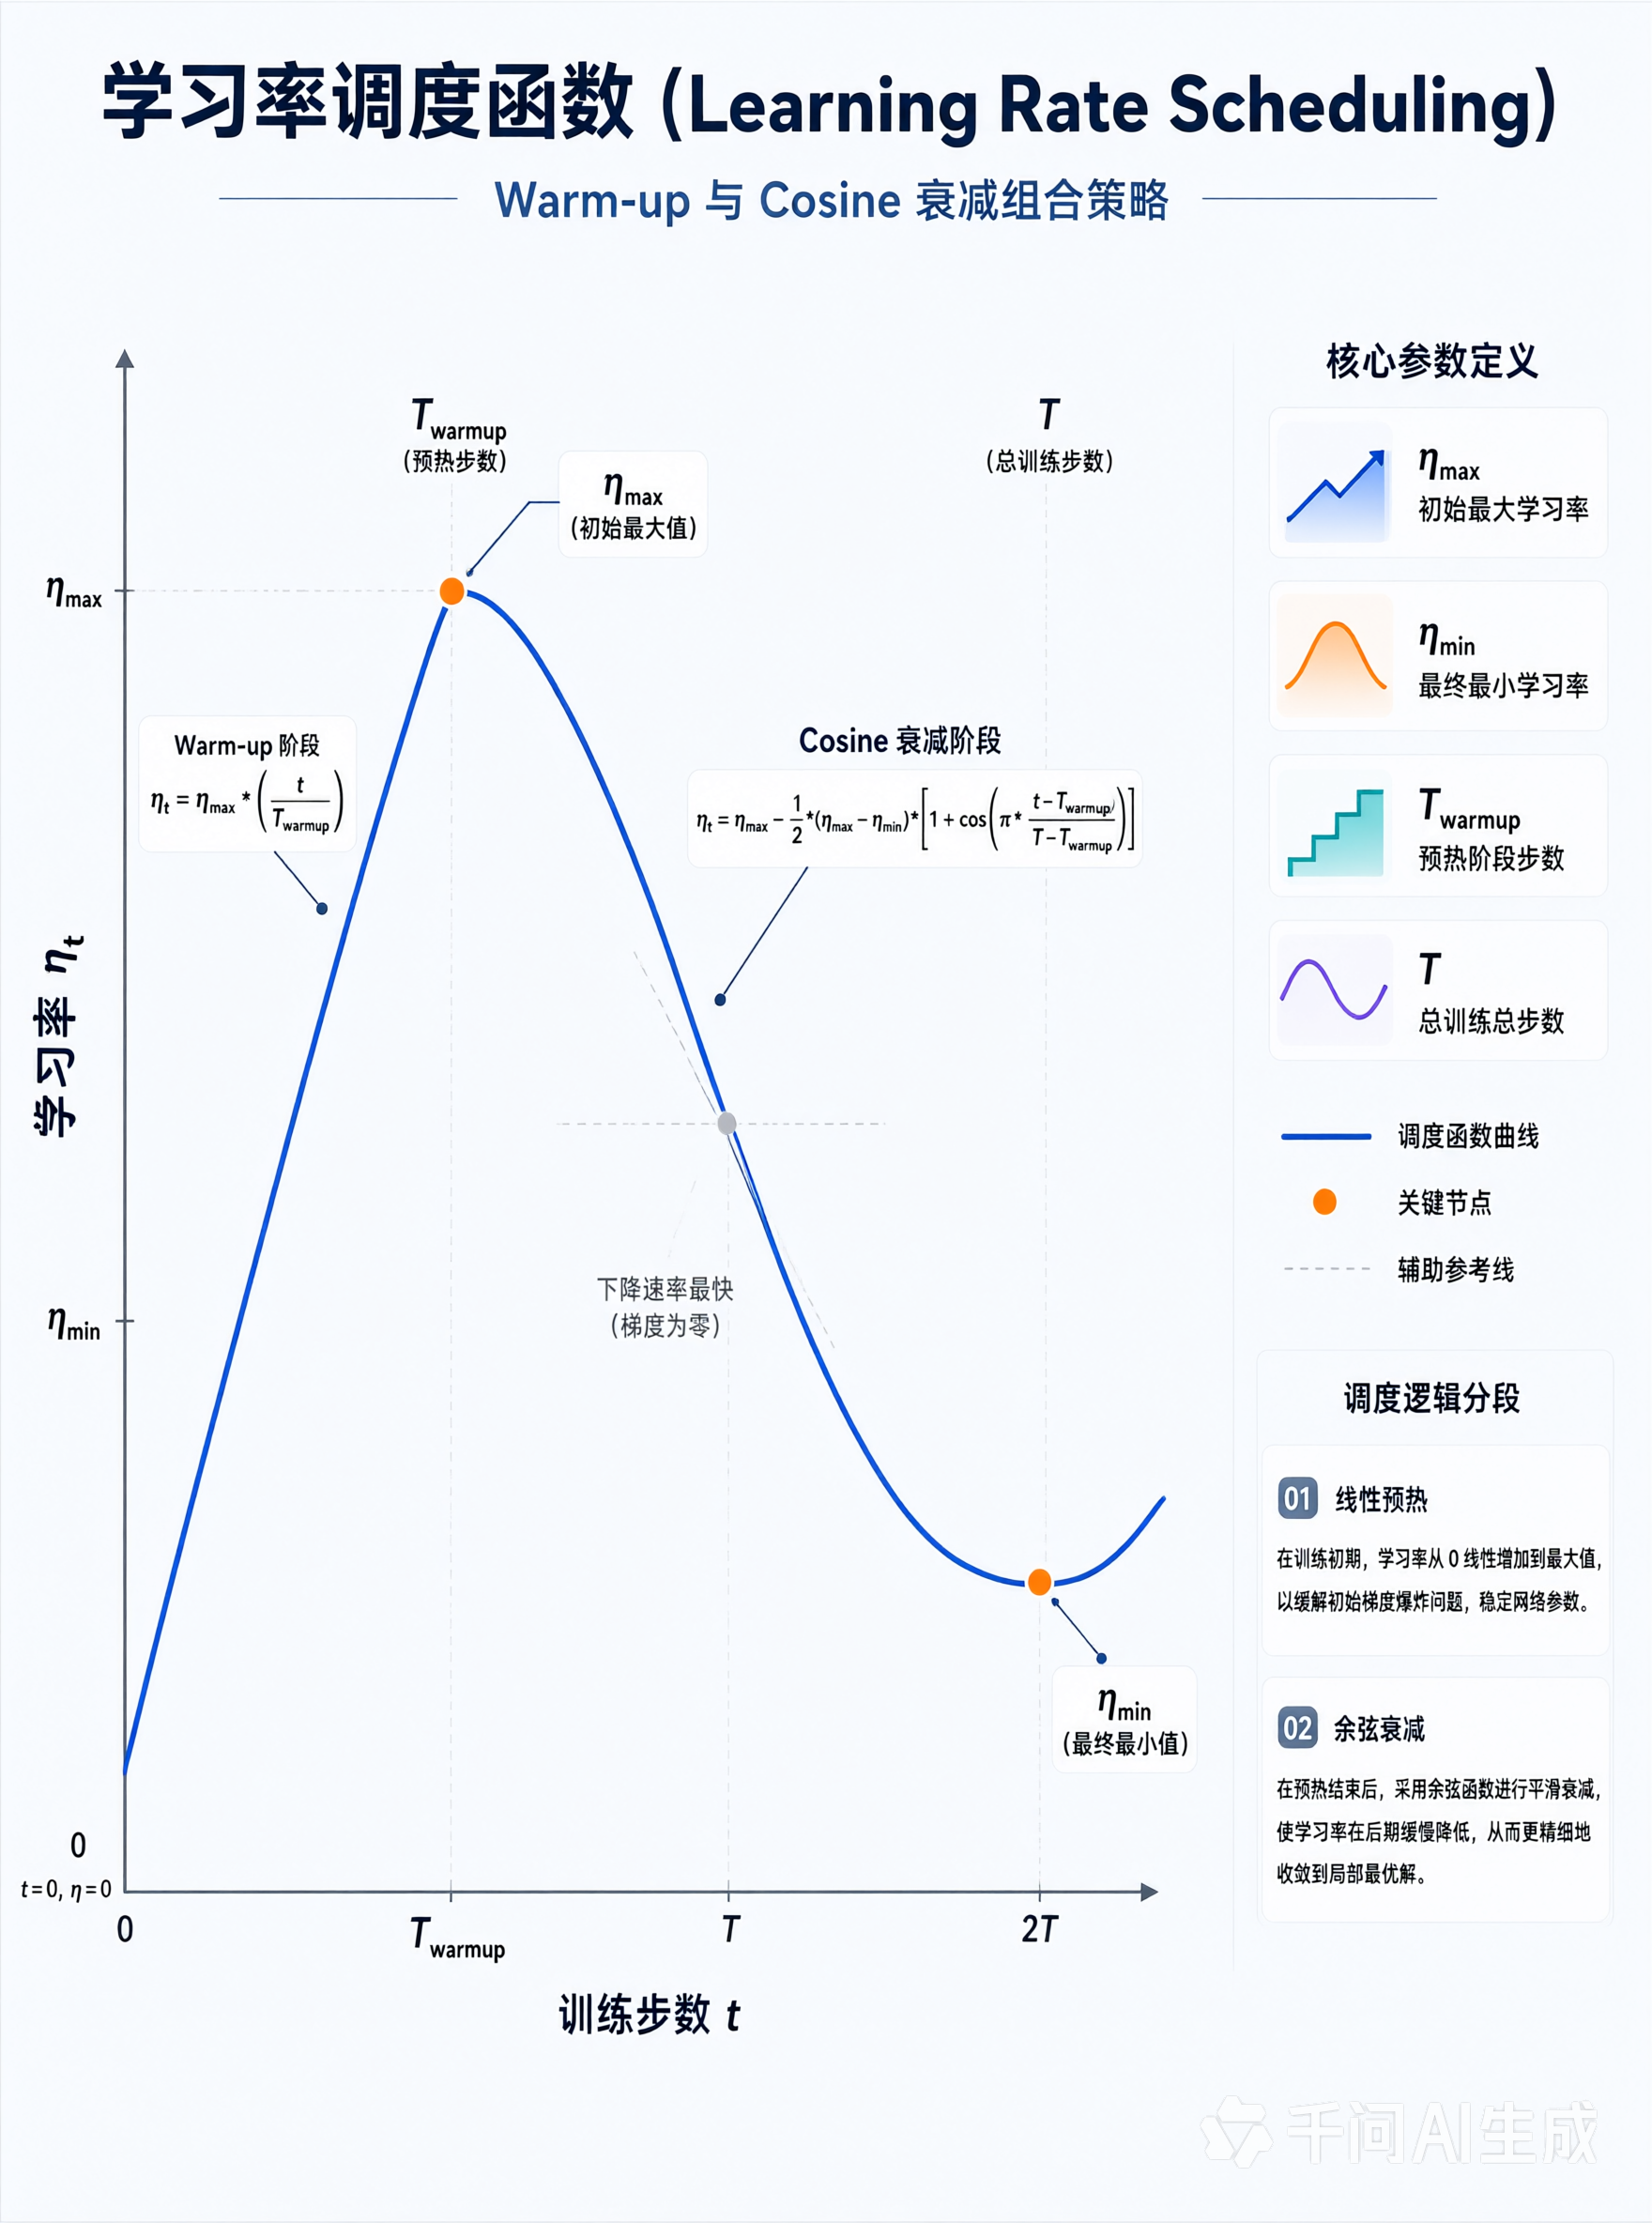
4. Constant、Linear、Cosine 对比
| 策略 | 公式特点 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Constant | 简单,调试方便 | 后期可能震荡 | 小实验、调试 | |
| Linear Decay | 线性下降 | 稳定、简单 | 后期可能过早变小 | BERT 类训练、常规微调 |
| Cosine Decay | 余弦下降 | 平滑、常用、后期稳定 | 多一个调度超参数 | 大模型预训练、视觉模型训练 |
代码理解:
python
from transformers import get_scheduler

scheduler = get_scheduler(
    optimizer = optimizer,
    name = 'cosine',
    num_warmup_steps = 1000,
    num_training_steps = 10000,
    lr_min_ratio = 1e-2
)

for step, batch in enumerate(dataloader):
    loss = model(batch).loss
    loss.backward()
    optimizer.step()
    scheduler.step()
    optimizer.zero_grad()
4.3.3 Peak Learning Rate 与 Minimum Learning Rate
Peak LR:最大学习率
Minimum LR:最小学习率
Peak LR 与 Batch Size 的关系
一般来说,batch size 越大,可以使用的 peak LR 往往越大。
因为大 batch 下梯度估计更稳定,当 batch size
因此可以承受更大的学习率。但这不是无限成立。过大的 batch 和学习率仍可能损害泛化或导致训练不稳定。
Peak LR 与 Minimum LR 的整体关系
在大模型训练中,minimum LR 常常设置为 peak LR 的一个比例,例如:
也有些训练直接让学习率衰减到 0。
4.3.4 大模型实践中的经验设置
预训练:linear warmup + cosine decay(
- 初期稳定,中期强学习,后期收敛
微调:linear warmup + linear decay,或 constant with warmup
- 步数少,peak LR 远小于预训练(
),防止破坏已有表示
4.4 Batch
4.4.1 Micro Batch、Global Batch 与梯度累积
在大模型训练中,Batch Size 不是一个单一概念。实际训练时至少要区分三个量:
其中:
| 名称 | 含义 |
|---|---|
| Micro Batch Size | 单张 GPU 一次前向/反向真正处理的样本数 |
| Gradient Accumulation Steps | 梯度累积步数 |
| Global Batch Size | 一次参数更新实际等价使用的总样本数 |
1. Micro Batch Size
Micro Batch Size 是指每张 GPU 在一次 forward/backward 中处理的样本数。
假设一张 GPU 一次只能放下:
那么每次前向传播时,这张 GPU 只处理 4 条样本。
2. Gradient Accumulation
显存有限时,不能直接把很大的 Batch 放进 GPU,于是可以用 梯度累积 模拟大 Batch。
普通训练是:
其中一次 forward/backward 后立刻更新参数。
梯度累积的做法是:将一个大 Batch 分小批次,连续做多次 forward/backward,但暂时不更新参数,而是把梯度加起来。
假设累积
累积后的梯度为:
然后再进行参数更新:
梯度累积的伪代码可以理解为:
python
optimizer.zero_grad()

for step, batch in enumerate(dataloader):
    loss = model(batch)
    loss = loss / accumulation_steps
    loss.backward()

    if (step + 1) % accumulation_steps == 0:
        optimizer.step()
        scheduler.step()
        optimizer.zero_grad()
3. Global Batch Size
Global Batch Size 是指一次 optimizer step 实际使用的总 batch size。
- GPU 数量为
; - 每张 GPU 的 micro batch size 为
; - 梯度累积步数为
。
4.4.2 Batch Size 与梯度噪声
假设 N 是全量训练数据总量,在大模型训练中这个数据量一般很大,实际训练不会每一步都用全部数据,而是采样一个 mini-batch(其实就是上面介绍的 Global Batch Size:
于是 mini-batch 梯度为:
它是完整梯度的随机无偏估计
如果假设单样本梯度的方差为:
那么 mini-batch 平均梯度的方差近似为:
即,Batch Size 越大,梯度噪声越小。大 batch 看似梯度更平稳,但有一个隐含代价:
同样遍历一遍数据,参数更新次数变少了。相当于模型"看"了同样多的数据,但"学"的次数变少了。
小 Batch 靠噪声探索,但梯度不稳定且并行效率低;
大 Batch 靠稳定加速,但参数更新次数少可能导致收敛变慢,因此常配合更大的学习率。
4.4.3 Critical Batch Size
当 batch size 小于某个范围时,增大 batch size 可以明显提升吞吐和稳定性。
但超过某个临界值后,继续增大 batch size 的收益下降:
此时:
- 梯度噪声已经很小,现有的梯度已经在很大程度上代表真实的优化方向,如果再增加每个 Batch 的样本,只是重复已有的信息;
- 相应的需要调大学习率,过大的 LR scaling 可能导致训练不稳定;
- 现在的大模型预训练通常是大规模的分布式训练,增大 Batch 会提高显存的需求,分布式训练的通信开销随规模非线性增长,代价很大。
4.5 训练的监控与 Checkpoint 管理
大模型预训练通常持续数天甚至数周,训练成本很高,因此不能只关注最终 loss。完整训练系统还需要解决两个问题:
- 如何判断训练是否正常;
- 如何在训练中断后准确恢复训练状态。
4.5.1 监控指标
一个典型训练监控面板可能包含:
| 指标 | 主要作用 |
|---|---|
| Train Loss | 判断模型是否持续学习 |
| Validation Loss | 判断泛化性能 |
| Learning Rate | 检查学习率调度 |
| Gradient Norm | 检测梯度爆炸/异常 |
| Tokens/s | 衡量训练吞吐 |
| Step Time | 检测训练速度异常 |
| GPU Utilization | 判断计算资源利用率 |
| GPU Memory | 监测 OOM 风险 |
| NaN/Inf | 检测数值稳定性问题 |
现代大模型训练非常关注
:global batch size; :sequence length; :一个 optimizer step 的耗时
如果 loss 正常,但 throughput 突然下降,则可能不是模型问题,而是:
- DataLoader 速度下降;
- 网络通信瓶颈;
- GPU 等待数据;
- Checkpoint 保存阻塞;
- 集群节点异常;
- 数据 Shuffle 或 I/O 出现瓶颈。
4.5.2 Checkpoint 管理
若在模型训练的过程中,我们通过监控指标发现有训练不稳定的情况,如果问题严重,我们就需要暂停训练,排查问题并及时修改。完成之后我们要如何恢复训练呢?这时就需要 Checkpoint。
Checkpoint 可以理解为:
训练过程在某一个时间点的完整快照。
最简单的 checkpoint 只有模型参数
一个完整 checkpoint 通常至少包含:
:模型参数; :optimizer state; :scheduler state; :当前 global step; :随机数状态; :其他训练元数据。